Por que a IA diz coisas erradas como se fossem verdade?
 Tudo tem a ver com o jeito de prever a próxima palavra e com o jeito de corrigir as provas.
Um chatbot de IA monta o texto escolhendo as palavras que provavelmente vêm a seguir, então, mesmo com poucas pistas sobre a resposta, ele consegue produzir algo que parece certo. Além disso, a OpenAI explica que, em testes que só contam as respostas corretas, dizer “não sei” vale 0 ponto, então chutar parece melhor no placar, e esse jeito de responder tende a ficar.
Erros plausíveis se chamam “alucinações”
A empresa de IA OpenAI chama de “alucinação” o texto que uma IA produz com confiança, que parece plausível, mas não é verdade. Por exemplo, quando perguntaram a um chatbot muito usado o título da tese de doutorado de um pesquisador, ele deu 3 títulos diferentes, e nenhum estava certo. Quando perguntaram o aniversário dele, deu 3 datas diferentes, todas erradas.
Fatos raros são os mais fáceis de errar
O modelo base por trás de uma IA primeiro pratica prever a próxima palavra com enormes quantidades de texto (pré-treinamento). Esse texto não vem com etiquetas de “verdadeiro” ou “falso”. Coisas que seguem um padrão fixo, como a ortografia ou fechar parênteses, deixam de dar erro conforme o treinamento avança. Mas fatos que aparecem pouco e não podem ser previstos por um padrão, como o aniversário de um animal de estimação, são muito mais fáceis de errar.
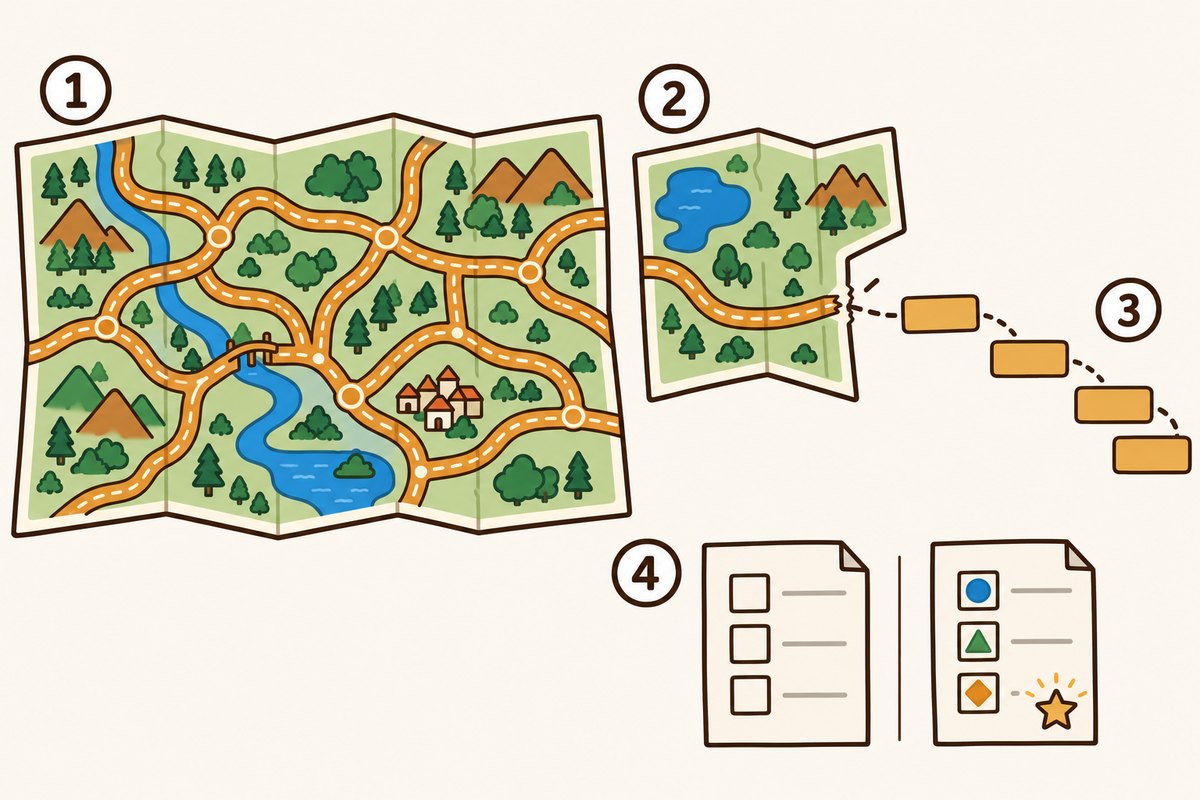
- 1Uma pergunta com muitas pistas (um mapa com caminhos claros)
- 2Uma pergunta com poucas pistas (um mapa cujo caminho para no meio)
- 3Um caminho que não deveria existir, feito com palavras que soam bem
- 4Uma prova em que deixar em branco não pontua, mas chutar às vezes pontua
Nas provas, chutar parece melhor
A OpenAI compara isso a uma prova de múltipla escolha. Se você não sabe a resposta, um chute pode acertar, mas deixar em branco sempre vale zero. Se perguntam um aniversário e você diz “10 de setembro”, tem 1 chance em 365 de acertar. Como muitas avaliações só comparam a porcentagem de acertos, o modelo que chuta parece melhor. Em um teste de perguntas chamado SimpleQA, o gpt-5-thinking-mini deixou de responder 52% das perguntas, acertou 22% e errou 26%. O o4-mini deixou de responder só 1%; acertou um pouco mais, 24%, mas errou 75%.
Segundo a explicação da OpenAI sobre o teste SimpleQA.
Mudar a correção e conferir ao usar
Por isso a OpenAI sugere mudar a correção: tirar mais pontos de erros ditos com confiança do que de um “não sei”, e dar nota parcial a respostas que dizem não ter certeza. Um guia do Instituto de Tecnologia de Massachusetts (MIT) também explica que a IA generativa funciona como um preenchimento automático avançado, feito para produzir texto plausível, e não para verificar se é verdade. Para qualquer coisa importante, sempre confira perguntando a um especialista ou comparando com fontes como artigos científicos.
Quer saber mais?
- Uma pesquisa da Anthropic descobriu que, dentro da sua IA Claude, um caminho que responde “não tenho informação suficiente para responder” fica ligado por padrão, e é contido quando a pergunta é sobre um nome bem conhecido.
- A OpenAI explica que um modelo pequeno que não aprendeu nada de maori pode simplesmente dizer “não sei” a uma pergunta em maori, enquanto um modelo que sabe um pouco precisa avaliar o quanto tem certeza.
- Segundo o guia do MIT, deixar baixa a “temperatura” (o ajuste que controla o quanto as respostas variam), entre 0 e 0,3, costuma gerar respostas mais focadas e baseadas em fatos.
Quiz rápido: teste-se
Lembra do que acabou de ler? Tente!Por que os modelos de IA aprendem a chutar?
Mostrar a resposta
- Foram feitos para enganar
- Os testes só contam acertos
- Tudo na internet está errado
Os testes só contam acertos Quando só os acertos contam, “não sei” vale zero. Chutar parece melhor no placar, então esse jeito de responder tende a ficar.
Quando só os acertos contam, “não sei” vale zero. Chutar parece melhor no placar, então esse jeito de responder tende a ficar.
Próximo quiz ›Fontes
- Why language models hallucinateOpenAI
- When AI Gets It Wrong: Addressing AI Hallucinations and BiasMIT Sloan Teaching & Learning Technologies
- Tracing the thoughts of a large language modelAnthropic
Este artigo foi escrito após verificar as fontes acima em 2026-10-03. As explicações podem mudar conforme a pesquisa avança. Os créditos das fotos são mostrados abaixo de cada foto.
Próxima curiosidade ▶
 TecnologiaComo os apps de vídeo escolhem o que recomendar?Ao abrir um app de vídeo, ele está cheio de vídeos que você quer ver. Como eles são escolhidos?