AI為什麼會把錯誤說得像真的一樣?
 關鍵在於預測下一個詞的方式,還有考試的評分方法喔。
AI聊天機器人是挑選「接下來最可能出現的詞」來組成句子,所以即使答案的線索很少,也能寫出聽起來很像樣的句子。而且OpenAI說明,在只計算答對題數的測驗裡,回答「不知道」是0分,用猜的反而成績看起來比較好,這種回答方式就容易留下來。
像樣的錯誤叫做「幻覺」
AI公司OpenAI把AI很有自信地寫出、聽起來合理卻不正確的句子,稱為「幻覺」(hallucination)。例如,向一個被廣泛使用的聊天機器人詢問某位研究者的博士論文題目,它給出了3個不同的題目,卻沒有一個是對的。問他的生日時,也給出3個不同的日期,全部都錯了。
很少出現的事實最容易出錯
AI背後的基礎模型,會先用大量文章練習預測下一個詞(預訓練)。這些文章並沒有貼上「正確」或「錯誤」的標籤。像拼字或括號的成對使用這種有固定規則的東西,隨著學習進行,錯誤會漸漸消失。但像寵物的生日這種很少出現、無法從規則推測的事實,就比較容易出錯。
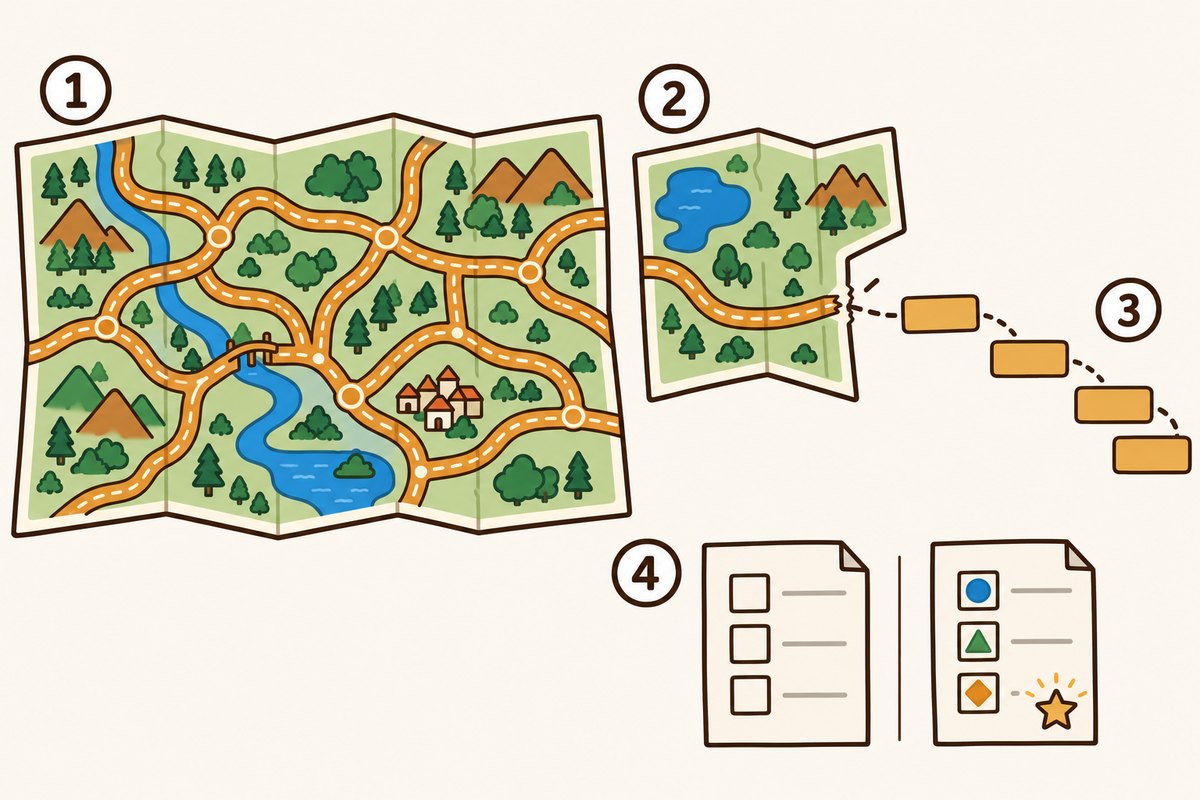
- 1線索很多的問題(道路清楚的地圖)
- 2線索很少的問題(道路走到一半就斷掉的地圖)
- 3用看似合理的詞語排出來、本來不存在的路
- 4空白不得分,用猜的填上有時卻能得分的考試
考試時,用猜的反而分數高
OpenAI用選擇題來比喻。不知道答案時亂猜一下,也許會猜中,但空白一定是0分。被問到生日時回答「9月10日」,有365分之1的機率猜中。因為很多評估只比較答對的比例,會猜的模型看起來成績反而比較好。在名為SimpleQA的問答測驗中,gpt-5-thinking-mini有52%的題目選擇不作答,答對22%,答錯26%。o4-mini不作答只有1%,答對24%稍微多一點,但答錯高達75%。
根據OpenAI公布的SimpleQA測驗結果。
改變評分,也靠使用者確認
因此OpenAI建議改變評分方式:對自信的錯誤扣比「不知道」更多的分,並給表達不確定的回答部分分數。麻省理工學院(MIT)的資料也說明,生成式AI就像進階版的自動完成輸入,目的是產生像樣的句子,而不是確認內容是否正確。重要的事,請一定要問專家或對照論文等資料來確認。
想知道更多
- Anthropic的研究發現,在AI「Claude」內部,有一個回答「資訊不足,無法回答」的機制預設是開著的,遇到有名的名字時,這個機制會被壓下來而開始回答。
- OpenAI說明,完全沒學過毛利語的小型模型,遇到毛利語的問題只要回答「不知道」就好;但學過一點的模型,就得判斷自己有多確定。
- 根據MIT的資料,把決定回答變化程度的「溫度」設定調低到0到0.3,回答通常會比較集中、偏向事實。
三選一小測驗
還記得剛剛讀的內容嗎?來挑戰看看吧!AI為什麼容易學會用猜的?
看答案
- 被做成會騙人
- 測驗只算答對題數
- 網路上全都是錯的
測驗只算答對題數 只算答對題數時,「不知道」是0分。用猜的成績看起來比較好,所以這種回答方式容易留下來。
只算答對題數時,「不知道」是0分。用猜的成績看起來比較好,所以這種回答方式容易留下來。
下一題 ›參考資料
- Why language models hallucinateOpenAI(英文)
- When AI Gets It Wrong: Addressing AI Hallucinations and BiasMIT Sloan Teaching & Learning Technologies(英文)
- Tracing the thoughts of a large language modelAnthropic(英文)
本文內容是在 2026-10-03 確認上列資料後撰寫的。隨著研究進展,說明也可能改變。照片的出處標示在各照片下方。
下一則冷知識 ▶
 科技影片App是怎麼挑出「推薦」的?打開影片App,滿滿都是想看的影片呢。它們是怎麼被挑出來的呢?