AI 聊天機器人是怎麼想出答案的?
 其實,它是一個詞一個詞挑出來,再串在一起的喔。
AI 聊天機器人收到問題後,會不斷重複一個步驟:挑出一個「接下來可能出現的詞」加上去,就這樣組成回答。為了做到這件事,它先用大量文章學習預測下一個詞,再經過調整,讓回答更接近人們評為比較好的答案。
把文字切成小小的「token」
你輸入聊天機器人的文字,首先會被切成叫做「token」的小單位。token 可能是一整個詞,也可能是詞的一部分,或只是一個字元。在 AI 裡面,文字就是以這一串 token 來計算的。
練習預測下一個詞,再做調整
根據 Anthropic(開發 AI「Claude」的公司)的說明,基礎模型會用大量文章,學習從前面的文字預測下一個詞,這叫做「預訓練」。不過在這個階段,它還不擅長回答問題或照著指示做事。所以之後會再進行額外的訓練,並用一種叫 RLHF 的方法:由人比較 2 個以上的答案並排出名次,讓模型更容易給出像排名較前面的答案。這樣它就被調整成好用的助理。
一個一個挑選、串起來
在寫回答時,它會根據你的問題和目前已經寫好的回答,挑出下一個 token 加上去。這樣重複很多次,就完成了整段回答。同一個問題每次得到的回答會有點不同,是因為有一種設定,會讓挑選下一個詞時帶有一些隨機性。
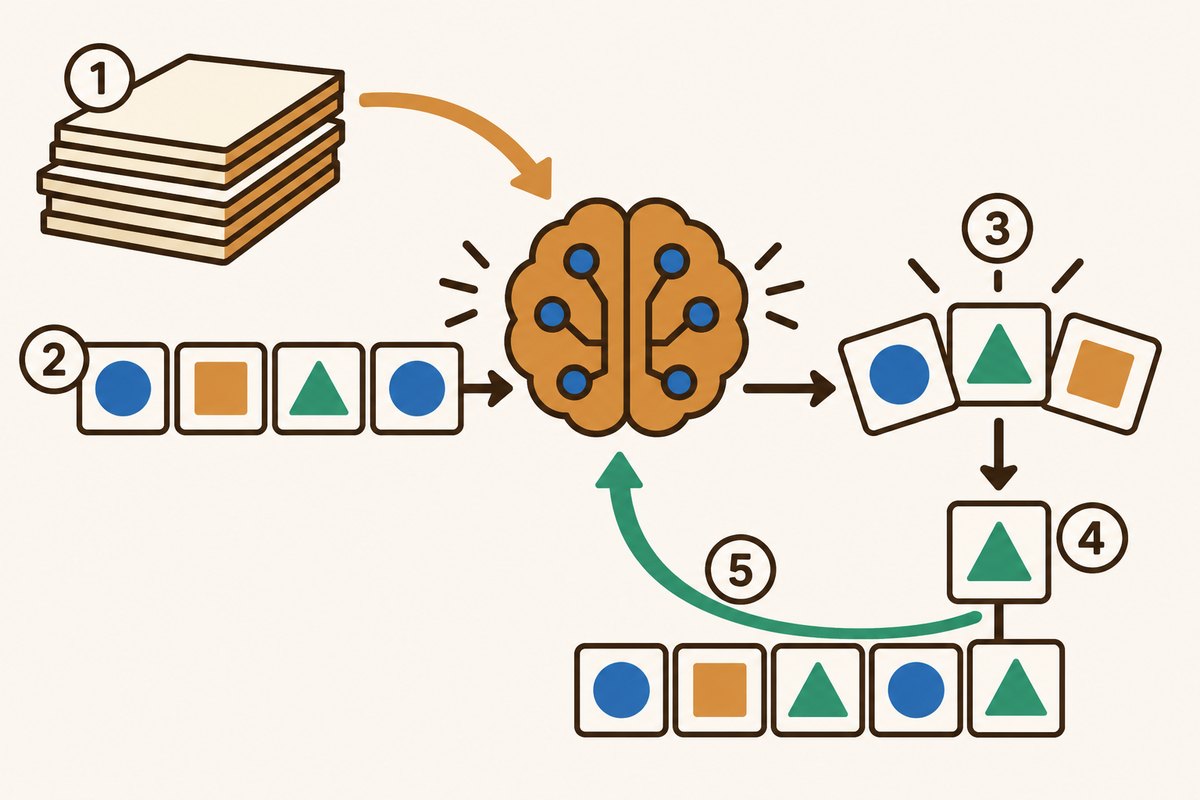
- 1用來學習的大量文章
- 2表示目前為止文字的詞語列
- 3接下來可能出現的詞語候選
- 4被選中的詞語
- 5一再重複「選一個、加上去」的流程
裡面發生了什麼,還在研究中
這些模型不是由人一條一條寫下規則做出來的,而是在訓練過程中,慢慢形成解決問題的方式。因此,就連開發它們的公司,對裡面發生的事情也還有很多不了解,研究仍在進行。2025 年的研究發現,寫詩時,模型會先準備好行尾押韻的候選詞,再寫出那一行。研究也發現,當需要的資訊其實不存在,卻有「好像看過」的反應啟動時,模型可能會寫出聽起來合理但不正確的內容。重要的事情,也請用其他資料確認。
想知道更多
- 在 Claude 以前的模型中,1 個 token 大約相當於英文的 3.5 個字元。
- 寫回答時能回頭參考的文字量有上限,這叫做「上下文視窗」。上限越大,越容易處理長篇文章。
- 一項關於加法的研究發現,有兩條路徑同時運作:一條算出大概的答案,另一條準確算出個位數。
三選一小測驗
還記得剛剛讀的內容嗎?來挑戰看看吧!AI 聊天機器人怎麼組成回答?
看答案
- 一個一個挑出下一個詞
- 直接抄網路上的答案
- 從固定的答案表裡找
一個一個挑出下一個詞 它會根據問題和目前寫好的內容,挑出下一個 token 加上去,不斷重複來組成回答。
它會根據問題和目前寫好的內容,挑出下一個 token 加上去,不斷重複來組成回答。
下一題 ›參考資料
- GlossaryAnthropic(Claude の開発者向け資料)(英文)
- Tracing the thoughts of a large language modelAnthropic(英文)
本文內容是在 2026-10-03 確認上列資料後撰寫的。隨著研究進展,說明也可能改變。照片的出處標示在各照片下方。
下一則冷知識 ▶
 科技手機螢幕怎麼感覺到手指?手機螢幕只要手指輕輕一碰就會反應呢。它到底感覺到了手指的什麼呢?